LIBERO
LIBERO 是一个旨在研究终身机器人学习的基准——机器人需要随着用户不断学习和适应,而不仅仅是预训练一次。它提供了一组标准化的操作任务,专注于知识迁移:机器人如何将已经学到的知识应用到新情况。通过在 LIBERO 上进行评估,可以公平地比较不同的算法,研究人员可以在彼此的工作基础上进行构建。
- 论文:Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub:Lifelong-Robot-Learning/LIBERO
- 项目网站:libero-project.github.io
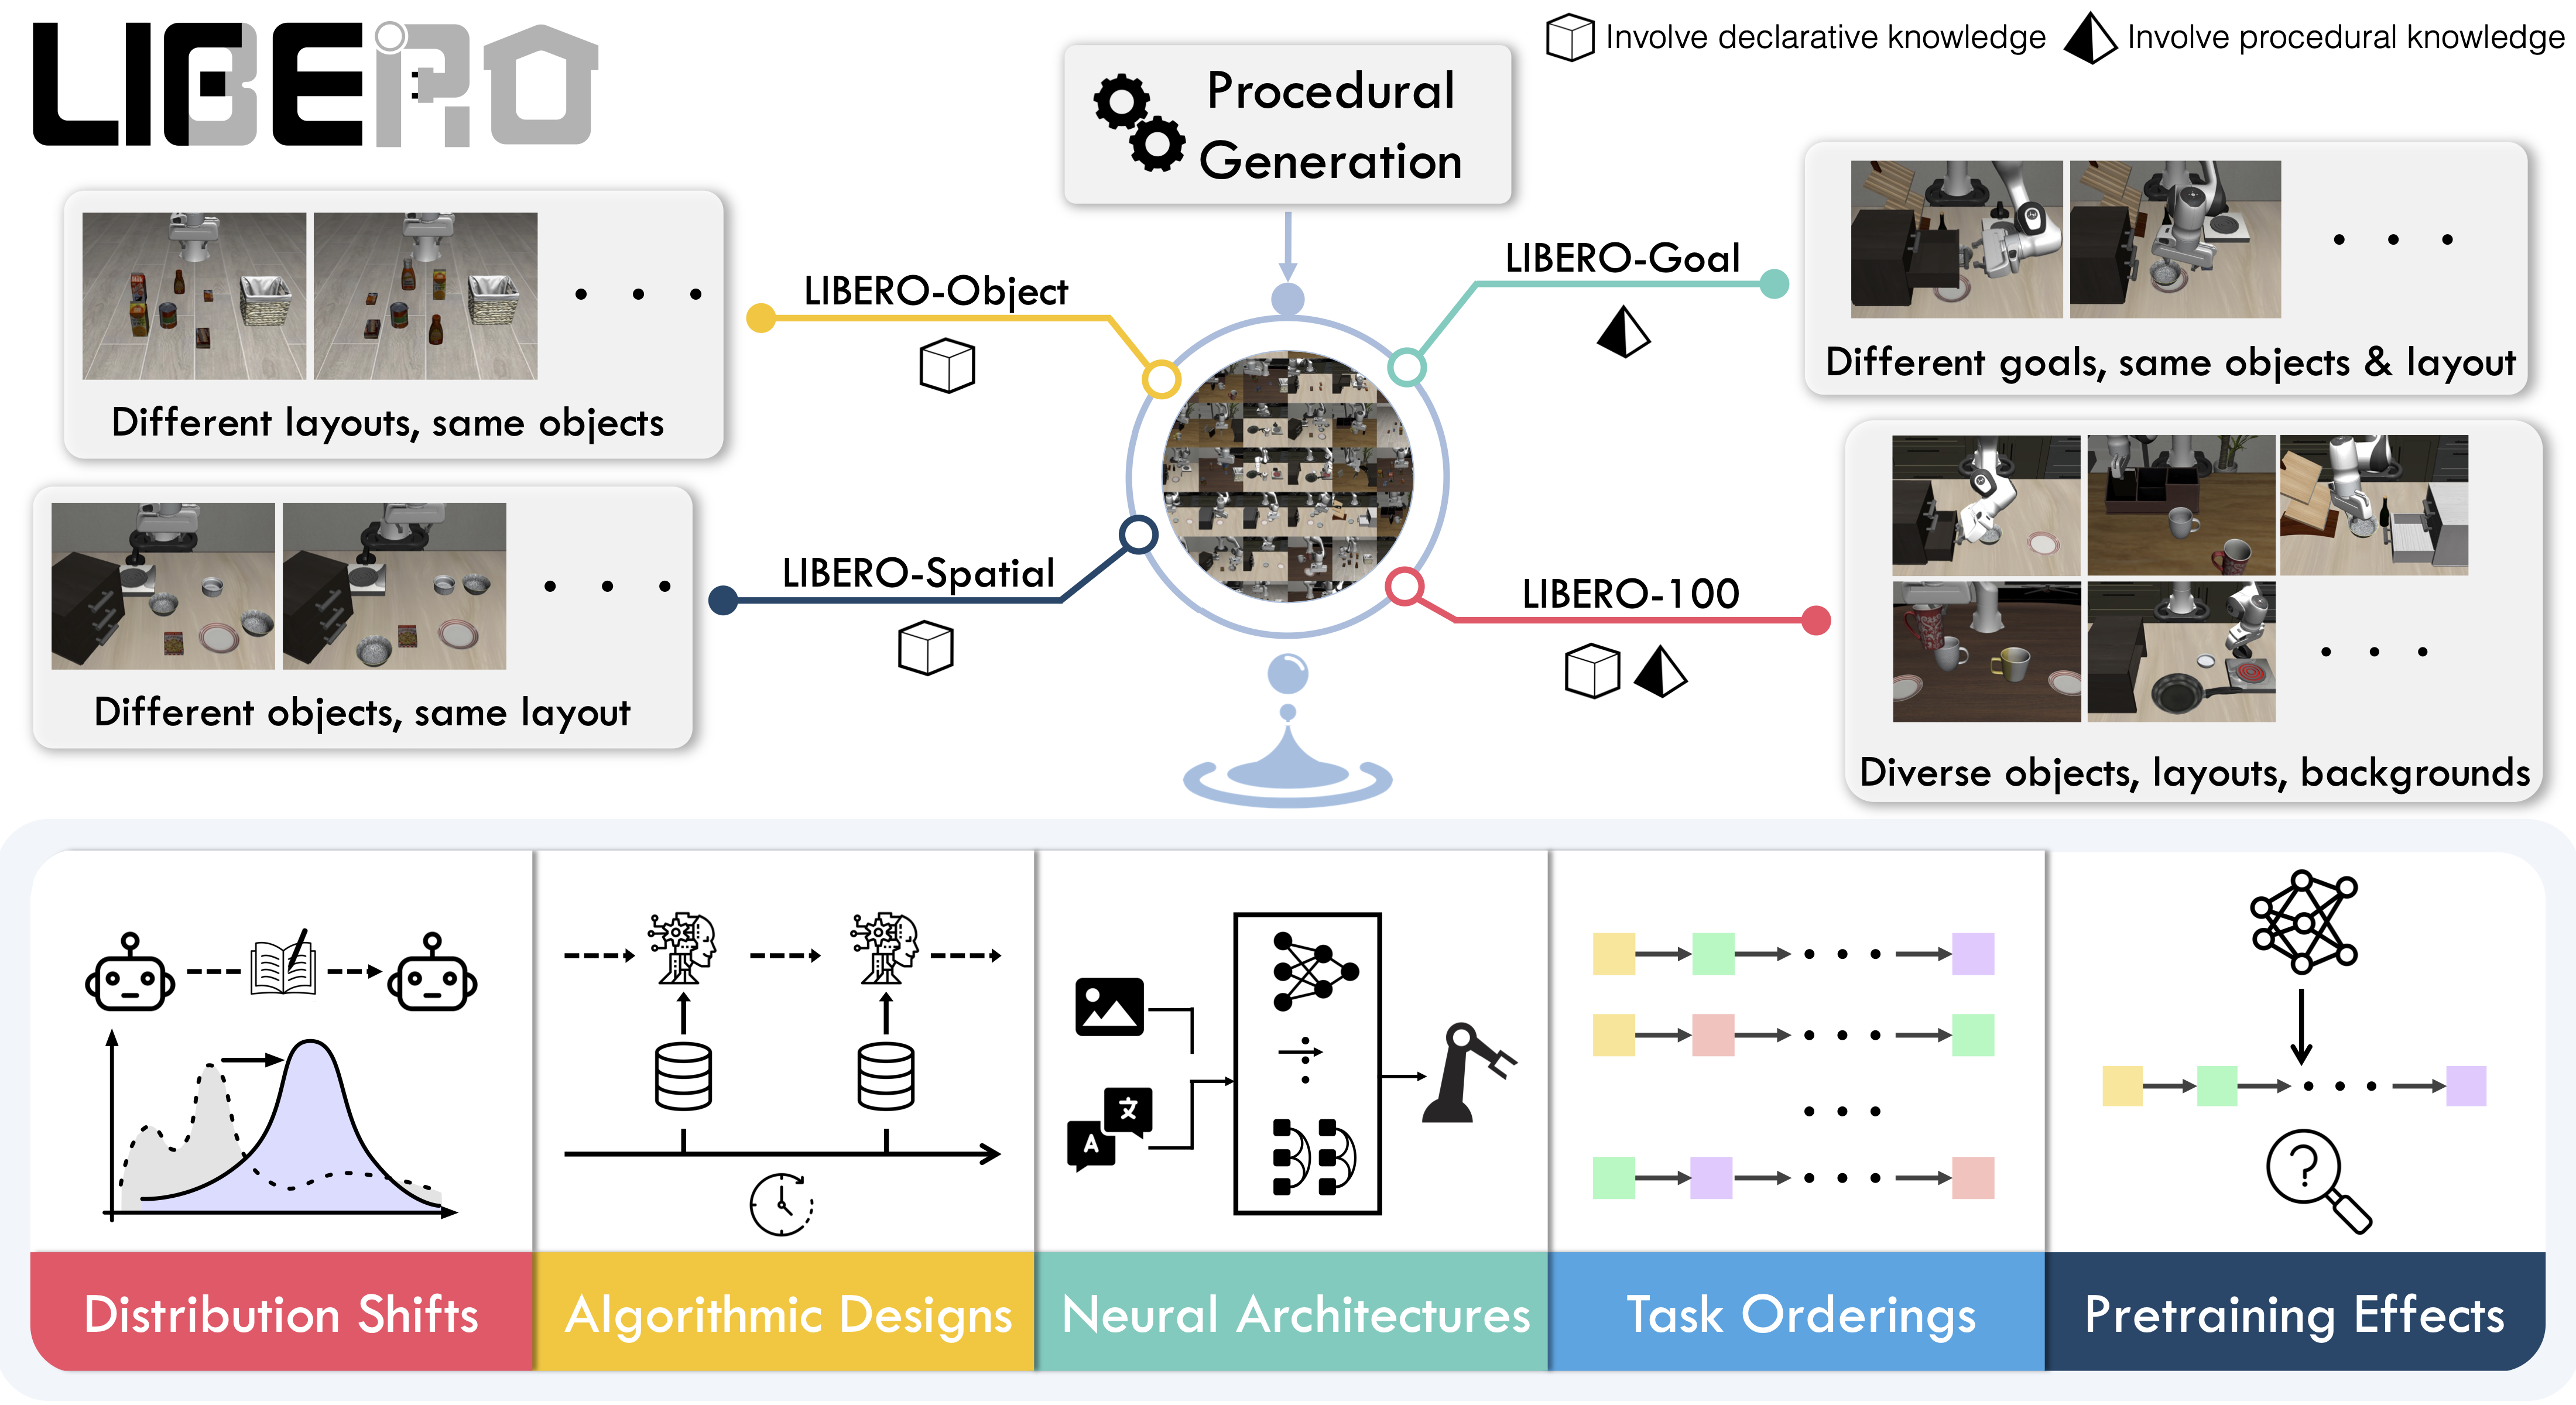
可用任务
LIBERO 包括五个任务套件,涵盖 130 个任务,从简单的物体操作到复杂的多步骤场景:
| 套件 | CLI 名称 | 任务数 | 描述 |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial |
10 | 需要空间关系推理的任务 |
| LIBERO-Object | libero_object |
10 | 以操作不同物体为中心的任务 |
| LIBERO-Goal | libero_goal |
10 | 具有变化目标的目标条件任务 |
| LIBERO-90 | libero_90 |
90 | 来自 LIBERO-100 集合的短时域任务 |
| LIBERO-Long | libero_10 |
10 | 来自 LIBERO-100 集合的长时域任务 |
安装
在遵循 LeRobot 安装说明后:
pip install -e ".[libero]"
Tip
LIBERO 需要 Linux(sys_platform == 'linux')。LeRobot 使用 MuJoCo 进行仿真——在训练或评估之前设置渲染后端:
export MUJOCO_GL=egl # 用于无头服务器(HPC、云)
评估
默认评估(推荐)
在四个标准套件上进行评估(每个任务 10 个回合):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
单套件评估
在一个 LIBERO 套件上进行评估:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
  --eval.n_episodes=3
--env.task选择套件(libero_object、libero_spatial等)。--env.task_ids限制为特定任务索引([0]、[1,2,3]等)。省略以运行套件中的所有任务。--eval.batch_size控制并行运行多少个环境。--eval.n_episodes设置每个任务运行多少个回合。
多套件评估
通过传递逗号分隔的列表,一次在多个套件上对策略进行基准测试:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
控制模式
LIBERO 支持两种控制模式——relative(默认)和 absolute。不同的 VLA 检查点使用不同的动作参数化进行训练,因此请确保模式与您的策略匹配:
--env.control_mode=relative # 或 "absolute"
策略输入和输出
观测:
observation.state— 8 维本体感受特征(末端执行器位置、轴角方向、夹爪 qpos)observation.images.image— 主摄像头视图(agentview_image),HWC uint8observation.images.image2— 腕部摄像头视图(robot0_eye_in_hand_image),HWC uint8
Warning
LeRobot 强制视觉特征使用 .images.* 前缀。确保您的策略配置 input_features
使用相同的命名键,并且您的数据集元数据键遵循此约定。如果您的数据包含不同的键,您必须重命名观测以匹配策略期望的内容,因为命名键被编码在归一化统计层内部。
动作:
Box(-1, 1, shape=(7,))中的连续控制 — 6D 末端执行器增量 + 1D 夹爪
推荐的评估回合数
为了可重现的基准测试,在所有四个标准套件(Spatial、Object、Goal、Long)上每个任务使用 10 个回合。这总共提供 400 个回合,并与用于发布结果的协议相匹配。
训练
数据集
我们提供了一个与 LeRobot 完全兼容的预处理 LIBERO 数据集:
作为参考,Physical Intelligence 发布的原始数据集:
示例训练命令
lerobot-train \
  --policy.type=smolvla \
  --policy.repo_id=${HF_USER}/libero-test \
  --policy.load_vlm_weights=true \
  --dataset.repo_id=HuggingFaceVLA/libero \
  --env.type=libero \
  --env.task=libero_10 \
  --output_dir=./outputs/ \
  --steps=100000 \
  --batch_size=4 \
  --eval.batch_size=1 \
  --eval.n_episodes=1 \
  --eval_freq=1000
复现已发布的结果
我们在 LIBERO 基准上复现了 Pi0.5 的结果。我们采用 Physical Intelligence LIBERO 基础模型(pi05_libero),并在 8 个 H100 GPU 上使用 bfloat16、批量大小为 256,使用 HuggingFace LIBERO 数据集进行额外 6k 步的微调。
微调后的模型:lerobot/pi05_libero_finetuned
评估命令
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
我们设置 n_action_steps=10,与原始 OpenPI 实现相匹配。
结果
| 模型 | LIBERO Spatial | LIBERO Object | LIBERO Goal | LIBERO 10 | 平均 |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
这些结果与 Physical Intelligence 报告的原始结果一致:
| 模型 | LIBERO Spatial | LIBERO Object | LIBERO Goal | LIBERO 10 | 平均 |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |